
苹果披露机器人大脑HALO 跑在千问模型上
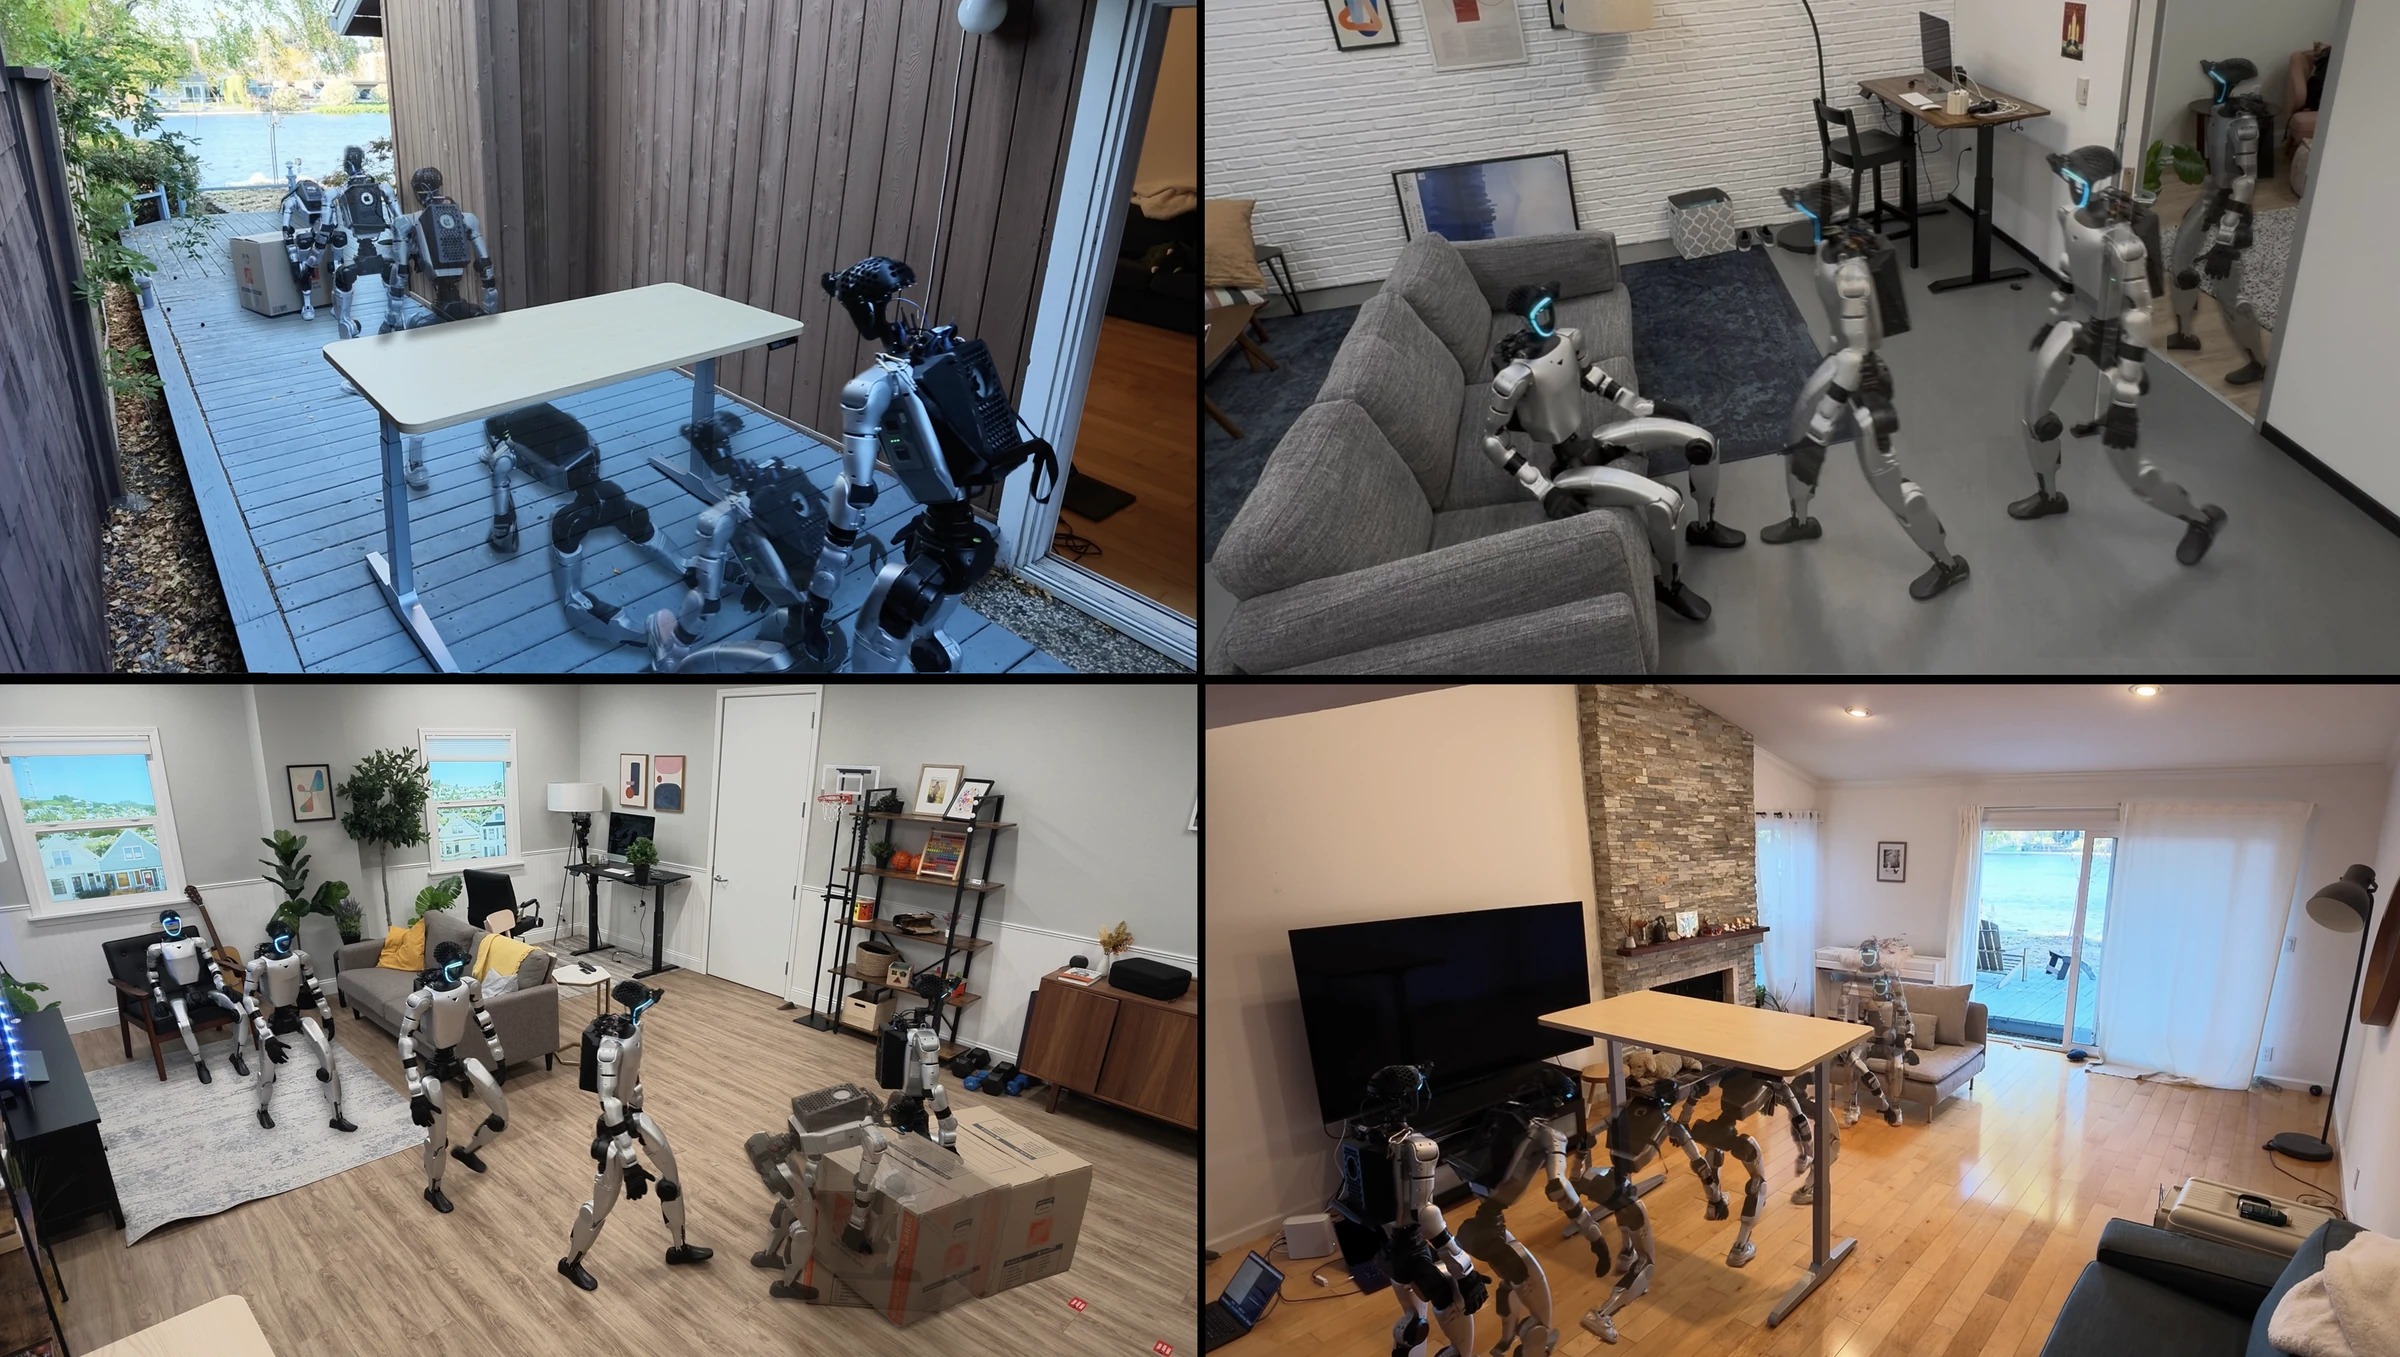
11 月 4 日,苹果研究团队在预印本平台 arXiv 提交论文《Perceptive Humanoid Motion from Simulation》,公开了一套名为 HALO 的人形机器人自主控制系统。它被装在一台宇树科技 G1 上,在六个从未见过、也没有提前扫描建图的真实家庭里执行 360 次任务,平均成功率 91%。
更值得注意的,是这台机器人的“大脑”装在哪里。HALO 的任务编排层默认在机器人背部的 Mac mini 上本地运行千问 Qwen3.6-35B-A3B 的 4-bit 量化版本,用 MLX 推理,与动作生成器共用同一个模型服务引擎,全程不需要联网;只有在需要更强的推理与规划时,才可以通过 API 改走云端模型。为此机器人后部加装了一台 Mac mini M4 Pro(64GB 内存),连同头部相机支架,整机重 37.56 公斤。
仿真里学会的动作,直接搬进陌生房间
训练数据来自程序生成的上千套住宅,附录统计为 1,178 个房间,合成 300 小时的 episode。团队没有依赖人工遥操作或穿戴动捕采集:缓存视觉语言特征用了 250 张 H100 约 9 小时,生成房间本身在最多 300 张 GPU 上跑 26 小时。论文的说法是,语料规模随算力扩展,而不是随人力扩展。
落到具体动作上,单任务在仿真与真实环境的成功率分别是:走向指定物体 98% 与 92%,坐下 84% 与 85%,侧身穿过半开的门 91% 与 93%,下蹲 95% 与 100%,俯身爬行穿过桌底 84% 与 90%,推箱子 93% 与 88%。串联多个动作的长任务掉得明显:穿门后走向指定物 71%(真实环境 100%)、下蹲接坐下 73%(真实 60%)、下蹲接走位再接推箱 64%(真实 50%),三项平均 69% 与 70%。
三层控制,两套计算
系统由三层协同:视觉语言模型编排器判断当前动作是否成功、失败就重试,并把下一步子任务交给动作生成器;生成器的编码器是冻结的 Qwen3.5-2B,读一张 224×224 的第一人称画面加一句自然语言指令,由 DiT 解码器输出 150 帧动作规划;底层动作跟踪器跑在机器人原厂的 Jetson Orin NX 上,配合一颗 55° 朝下的 RealSense D435i 输出关节指令。头部 OAK-1W 相机提供 120° 视野、1280×800、30fps 的画面,两套计算之间用 ZeroMQ 连接,整机无线缆。
论文同样写明了限制。新增物理任务仍要人工编写提示词、设计动作关键帧,部分动作借用了人类视频或动捕素材;机器人主要依赖视觉感知,一旦物体离开相机视野或被遮挡,涉及较多接触的任务表现就会下滑,加入触觉感知被列为后续方向。数据生成、模型训练与部署代码连同演示视频已在项目页面开源。
