
新 Mac 把内存带宽卷到 1.2TB/s:AI 电脑为何集体死磕「内存墙」
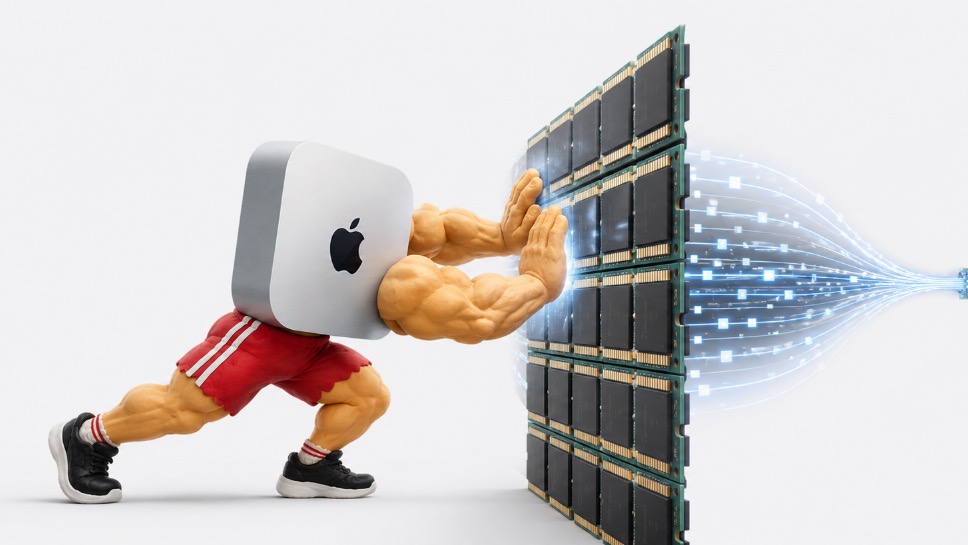
苹果新 Mac 的看点不只是芯片型号。官方把小巧的 Mac mini 直接定义成全天候跑 Agent 的生产力工具,Mac Studio 更是给到最高 512GB 统一内存——但真正拉开差距的参数,藏在过去少有人关心的「内存带宽」里。
一个被忽视的参数,成了 AI 电脑的分水岭
标准版 M6 的统一内存带宽达到 170GB/s,M5 Pro 版本推到了 307GB/s,顶配 M5 Ultra 更是跨过 TB 级大关,干到了 1.2TB/s。无独有偶,就在新 Mac Studio 亮相前一天,小米公布的端侧 AI 加速芯片玄戒 O100 同样把内存带宽做到了 1.22TB/s;而英伟达最新的消费级旗舰显卡 RTX 5090 凭借 32GB GDDR7 显存,带宽接近 1.8TB/s。
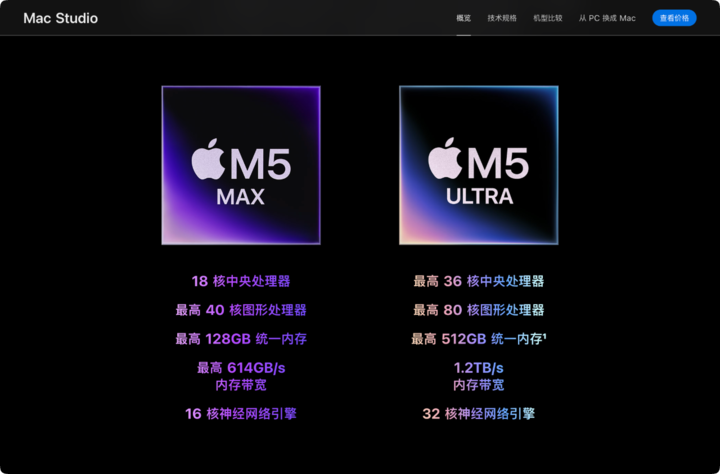
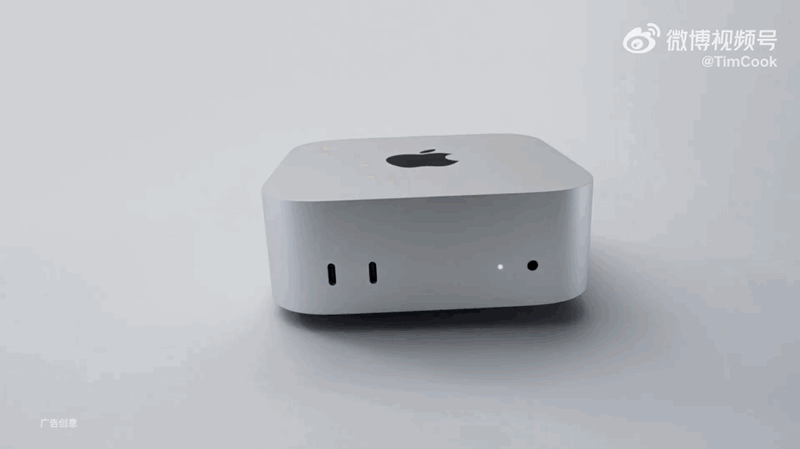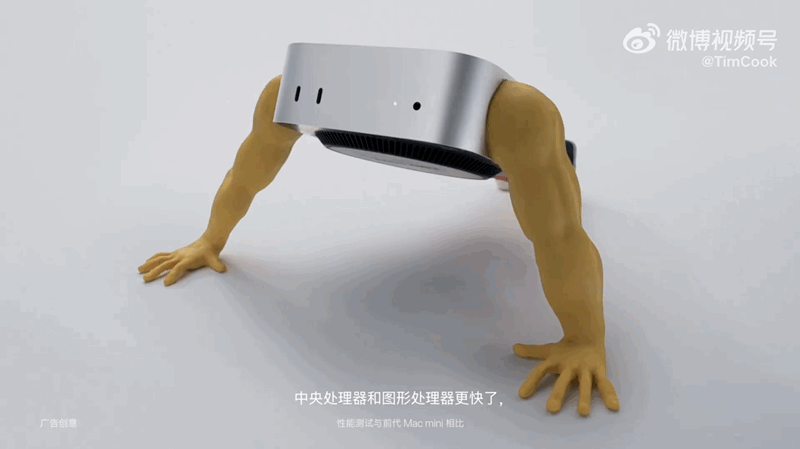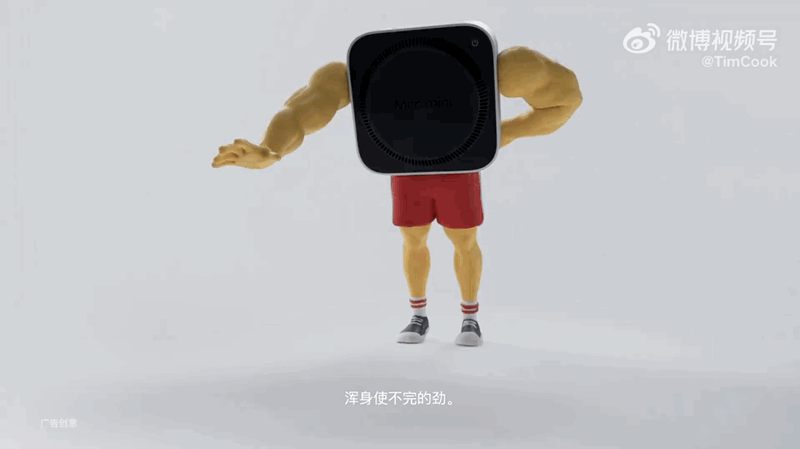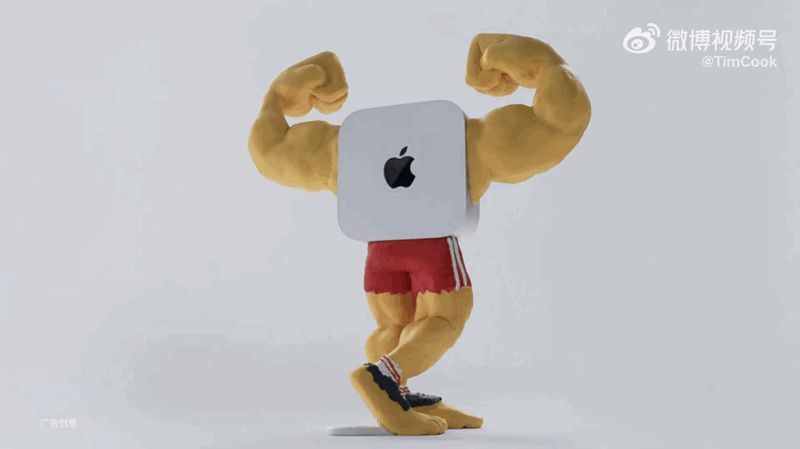
桌面 SoC、端侧专用 NPU 与独立 GPU 的架构路径大相径庭,但做电脑的、做手机芯片的、做显卡的,都在不约而同干同一件事——让内存里的数据跑得更快。苹果甚至还给 Mac mini 拍了一支「牛来」宣传片,让银色小方盒长出粗壮的肌肉手臂。
算力越来越快,却越来越容易「吃不饱」
很多人选内存只看容量:能装下多大的模型。带宽决定的则是另一件事——数据每秒能以多快的速度喂给计算核心。大模型一旦跑起来,最消耗资源的往往不是计算本身,而是贯穿始终的「搬数据」:在自回归生成阶段,每生成一个新 token,计算单元就得把内存里几十亿、上百亿的参数权重完整读取一遍。
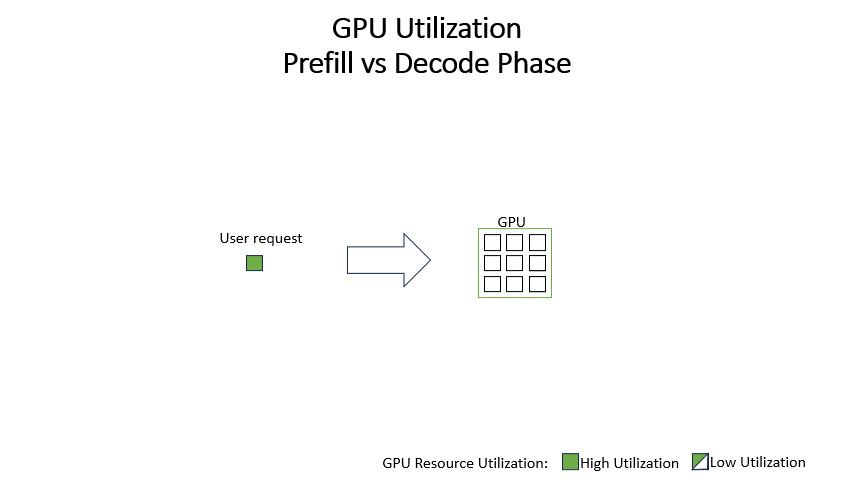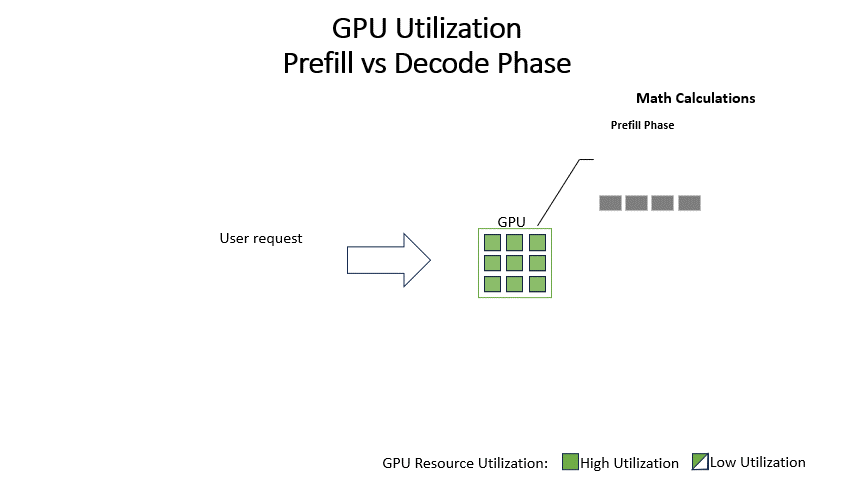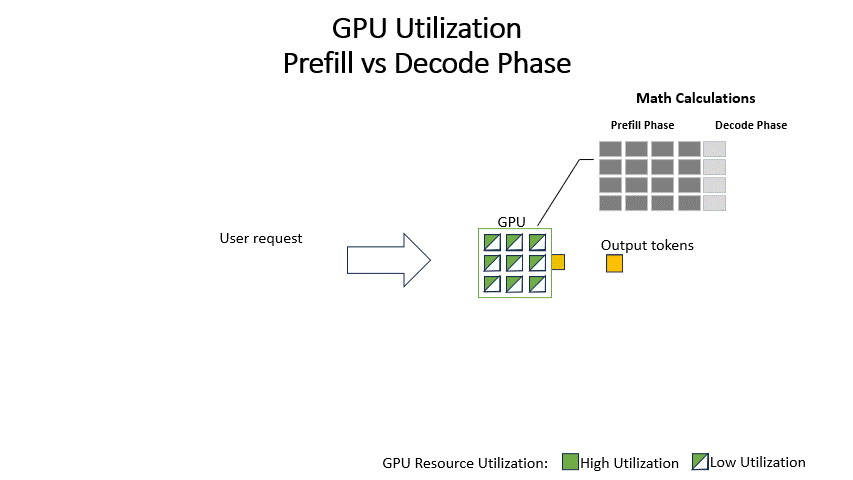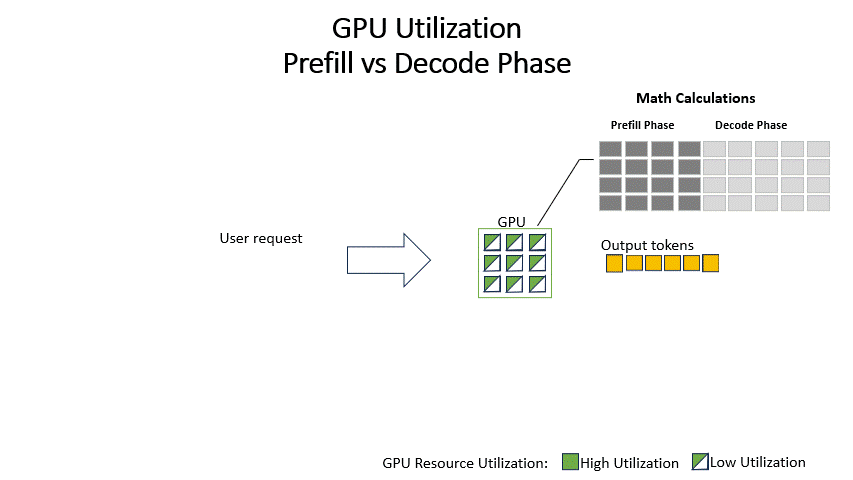
就像后厨里手速极快的大厨,翻炒只要两分钟,配菜师傅却半天才送来一盘切好的食材——大厨炒得再快,多数时间也只能握着锅铲干等。不管 CPU、GPU 还是 NPU,如今都卡在这道坎上,这种现象在体系结构中被称为 memory-bound(内存受限)。
更快的内存,也更贵
要让数据跑得更快,不能只靠堆颗粒,还得用更宽的位宽、更高频的接口和复杂的先进封装。以 AI 服务器标配的 HBM 为例,它把多层 DRAM 芯片垂直打孔堆叠,制造难度远超传统内存。TrendForce 的调查数据显示,由于 AI 数据中心对 HBM 和高规格服务器 DDR5 的需求暴增,三星、SK 海力士、美光正全力把先进晶圆产能向企业级倾斜,直接挤压了消费级 PC 内存的供给,即便在传统淡季,合约价仍持续环比上涨。去年底美光宣布逐步退出 Crucial(英睿达)消费级内存业务,也是同一逻辑下的选择——普通装机者加装一根内存条的预算,无形中正和全球 AI 数据中心抢夺着同一批晶圆。
四条突围路线
为了不让算力卡在数据搬运上,芯片界给出了各自的解法。最直观的是「物理加宽车道」:RTX 5090 用 512-bit 超宽位宽配合 GDDR7 硬拉带宽,AI 数据中心则在 GPU 身边塞满 HBM 堆栈,代价是极其高昂。其二是「把存储搬到计算隔壁」:小米玄戒 O100 采用晶圆级垂直堆叠,把两层 DRAM 晶圆直接压在 NPU 计算晶圆上方,用微米级的垂直互联换来 1.22TB/s 的端侧带宽。
其三是消除冗余搬运与向外扩展:苹果的统一内存让所有计算核心共享同一块内存池,省去 CPU 内存与 GPU 显存之间的来回拷贝;当单台设备装不下超大模型时,M5 Pro 版 Mac mini 的 3 个雷雳 5 端口、Mac Studio 上最高 120Gb/s 的雷雳 5 与 RDMA 技术,还能把多台设备串成集群——4 台 Mac Studio 组建的分布式推理集群,能跑出接近单机 3 倍的吐字吞吐。其四则更大胆:PIM 与存内计算尝试把计算单元直接塞进内存颗粒附近,让数据少跑路,尽管通用性与编译器生态仍待成熟。
三十年前的预言,今天的考题
这些问题其实并不新鲜。早在 1995 年,计算机科学家 William A. Wulf 和 Sally A. McKee 就在论文《Hitting the Memory Wall》中指出:处理器算力的增速远快于内存带宽,剪刀差持续扩大,处理器终将把越来越多时间耗在等待数据上。三十年过去,这堵「内存墙」从未消失,只是大模型的爆发以前所未有的速度把整个行业推到了它面前。
有意思的是,在这个连海报都能一键交给 AI 生成的时代,苹果这次给 Mac mini 拍宣传片反而用了「古法手作」——从草图到手工雕刻微缩模型、焊接机械联动结构,镜头里大多真有一个拿在手里的实体道具。这恰好映照了芯片底层的处境:无论上层的 AI 模型如何神乎其神,底层硬件依然逃不开最朴素的物理法则。过去几十年我们想尽办法让计算机算得更快,而 AI 带来的新命题,是如何让数据跟得上它。